MiniMax模型解析:如何平衡智能表现与推理成本
MiniMax破解智能与成本难题
计算成本降至1/20的技术闭环
本文深度解析MiniMax如何平衡大模型智能表现与推理成本,揭示其通过自研MSA架构将计算成本降低至1/20的技术路径,为AI从业者提供降本提智参考。
在AI大模型行业面临“智能提升”与“成本可控”两难困境时,MiniMax给出了独特的解法。本文将深入剖析MiniMax如何通过技术重构,打破Scaling Law带来的成本桎梏,实现推理效率与智能水平的双重突破。
一、行业痛点:智能与成本的两难
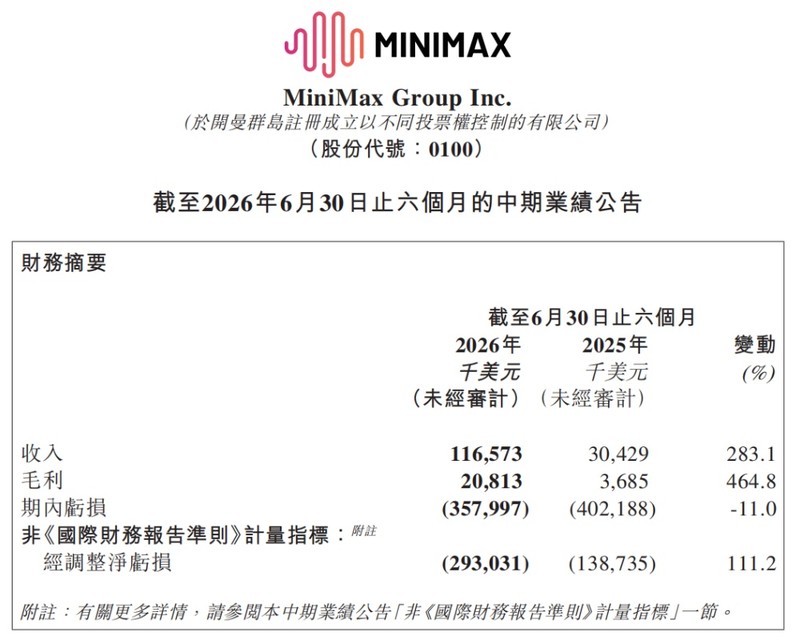
当前大模型行业正陷入一场深刻的博弈:智能表现与推理成本的平衡几乎成为不可调和的矛盾。按照传统的Scaling Law路径,模型参数规模已堆砌至2-3T级别,这种暴力堆料虽提升了上限,却让推理成本变得不可忽视。正如黄仁勋近期所言,单纯的训练支出时代正在落幕,推理已成为主要工作负载并呈快速扩张态势。对于开发者而言,这意味着每一次Token的生成都在真金白银地消耗算力。
面对这一困境,头部厂商选择了截然不同的突围路径。谷歌采取了“轻量化优先”的策略,推出了Gemini 3.7 Flash等低延迟模型,但令人玩味的是,其旗舰产品Gemini 3.5 Pro至今仍未正式面世,似乎在性能与成本之间选择了暂时的妥协。反观国内,月之暗面的Kimi K3将参数规模推高至约2.8万亿,随之而来的是API定价的大幅上涨,甚至被迫暂停了C端新订阅服务,以维持商业模型的可持续性。这种“高智能高成本”与“低成本低智能”的二元对立,让行业陷入了“鱼与熊掌”的艰难抉择。MiniMax正是在这种僵持中,试图寻找第三条路。
二、MiniMax核心逻辑:最小化成本最大化智能

MiniMax CEO闫俊杰提出了一句极具穿透力的技术口号:Minimize the Inference Cost, Maximize the Intelligence(最小化推理成本,最大化智能)。这一理念的核心在于打破传统认知中智能与成本的零和博弈,将其统一为同一目标的两面。在MiniMax的技术哲学中,推理不再仅仅是模型输出的最终结果,更被重新定义为制造下一代智能的“生产资料”。
这种定义带来了两个关键维度的转变:一方面,推理过程生成的合成数据与RL Rollout(强化学习回溯)是模型自我进化的燃料,推理质量直接决定数据质量;另一方面,推理成本的优化构成了智能迭代的必要条件,它划定了模型迭代的边界与频率。若推理成本过高,模型迭代的周期将被迫拉长,从而错失技术窗口。因此,MiniMax选择将推理效率作为核心指标,从模型设计的第一天起就贯穿整个研发周期,确保每一次迭代都能在可控成本下实现智能跃迁。这一理论基石,为后续通过特定架构实现降本增效提供了明确的方向。
三、技术实现:MSA架构与算力闭环
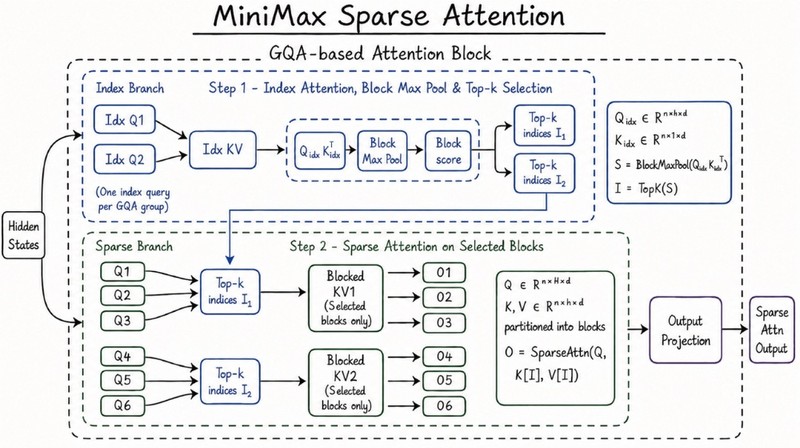
理念落地需要硬核技术的支撑,MiniMax给出的答案是其自研的MSA(稀疏注意力)架构。传统Transformer在处理长文本时,计算量往往随上下文长度呈平方级增长,导致成本难以控制。MSA架构的核心突破在于实现了总参数量与激活参数量解耦:前者决定了模型的知识容量上限,后者则直接决定了处理单个Token的计算开销。通过这种设计,MiniMax在保持海量知识储备的同时,大幅降低了实际运算时的资源消耗。
数据显示,在1M上下文场景下,新架构每Token的计算量仅为上一代的1/20,这一数量级的降幅直接打破了长文本推理的成本瓶颈。当然,算法优化离不开基础设施的高效支撑。MiniMax在算力层面同样下了重注,其ETTR(有效训练时间比例)高达97%。这意味着算力资源几乎被完全利用,极少出现闲置或等待损耗,从而为3T级文本及视频模型的持续迭代提供了稳定的能源保障,形成了从算法架构到算力调度的完整技术闭环。
- 相关标签:
- MiniMax
ControlNet Aux DWPose故障排查:从诊断到修复
2026-09-01
高通副总裁谈HBC优势:性价比超HBM且支持2bit量化
2026-08-31
高通跃龙IQ10交付进展:机器人产品已在中国量产
2026-08-31
VITURE与影之刃零合作:推出可玩3A游戏的XR眼镜
2026-08-31
HICOOL 2026项目揭榜:北京如何布局超万个创业赛道
2026-08-31
Anthropic通用接口:Agent接管显微镜与机械臂场景
2026-08-31
时代百大AI人物揭晓:吴泳铭李飞飞等11位华人上榜
2026-08-31
腾讯Hy4 preview实测:单提示词生成3D开放世界游戏
2026-09-01
阿里Qoder上线:推动编程能力从内部向外部延伸
2026-08-31
Chrome浏览器禁止网站获取地理位置权限设置
2026-09-01- 1阿里Qwen-Audio-3.0系列语音模型上线_在国际评测中取得优异成绩2026-08-17
- 2无剪辑基础如何使用 Seedance 2.0 制作漫剧2026-09-06
- 3QClaw_MySQL全流程运维2026-09-07
- 4苹果HomePod mini 2或于今秋发布_搭载全新AI芯片实现硬件升级2026-08-17
- 5Perplexity 长文章生成逻辑中断问题_分章节生成方案2026-09-06
- 6如何使用DeepSeek写检讨书2026-09-06
- 7Cowork新增内置浏览器功能 提升办公协作效率体验2026-08-28
- 8UP简历对话生成功能操作流程_简历生成实操步骤演示2026-08-23
- 9WorkBuddy权限审计报告如何生成 符合等保要求的安全自查方法2026-09-08
- 10Agent Space从需求分析到代码交付的AI开发流程2026-09-01